
Em poucas linhas
- Começar a resposta do Olmo-3-7B com “.\n\nOkay” sobe o acerto no MATH-500 de 42% para 78%, acima dos 75% da versão treinada com aprendizado por reforço.
- O RL concentra a mudança nas duas primeiras posições da resposta e torna essas aberturas muito mais prováveis; fixá-las recupera boa parte do ganho.
- Trocar “okay” por “chicken” nos dados de treino faz “Chicken” virar gatilho de raciocínio: de 2,4% para 37,2% no MATH-500.
- As mesmas aberturas mudam o que o modelo recusa: com “ Okay,” ele dá respostas nocivas a 42,4% dos pedidos perigosos; com “.\n\nOkay”, a 0,2%.
Pesquisadores do MIT, da UC Berkeley, da Universidade de Washington e do Allen Institute for AI mostraram que basta fixar os dois primeiros tokens da resposta de um modelo base para ele raciocinar quase tão bem quanto a versão treinada com aprendizado por reforço (RL). No Olmo-3-7B, começar a resposta com um ponto, duas quebras de linha e a palavra "Okay" eleva o acerto no MATH-500 de 42% para 78%; a versão com RL chega a 75%. Os autores também provaram que o efeito vem dos dados de treino: substituindo "okay" por "chicken" no material de treino, a palavra "Chicken" passou a disparar raciocínio. O paper, publicado no arXiv em 5 de outubro de 2026, entra no centro de um debate caro à indústria: quanto do raciocínio dos modelos atuais o RL ensina, e quanto ele apenas tira de onde já estava.
O problema
Desde o DeepSeek-R1, em janeiro de 2025, a receita dominante para criar modelos de raciocínio é aplicar RL com recompensas verificáveis: o modelo tenta resolver problemas de matemática ou código, e só recebe recompensa quando acerta. Comportamentos como revisar a própria conta e dizer "espera, deixa eu conferir" foram descritos como emergentes desse treino. A equipe do DeepSeek chamou isso de "momento aha".
Ver um comportamento depois do RL, porém, não prova que ele não existia antes. Um trabalho de 2025 de Yue e colegas argumentou que o RL com recompensas verificáveis desloca probabilidade para trajetórias de raciocínio que o modelo base já sabia produzir, sem ampliar de fato a capacidade. Outros mostraram que técnicas de prompt e de busca na decodificação extraem raciocínio de modelos base. A pergunta que o paper faz é bem concreta: qual é a menor intervenção capaz de destravar esse raciocínio?
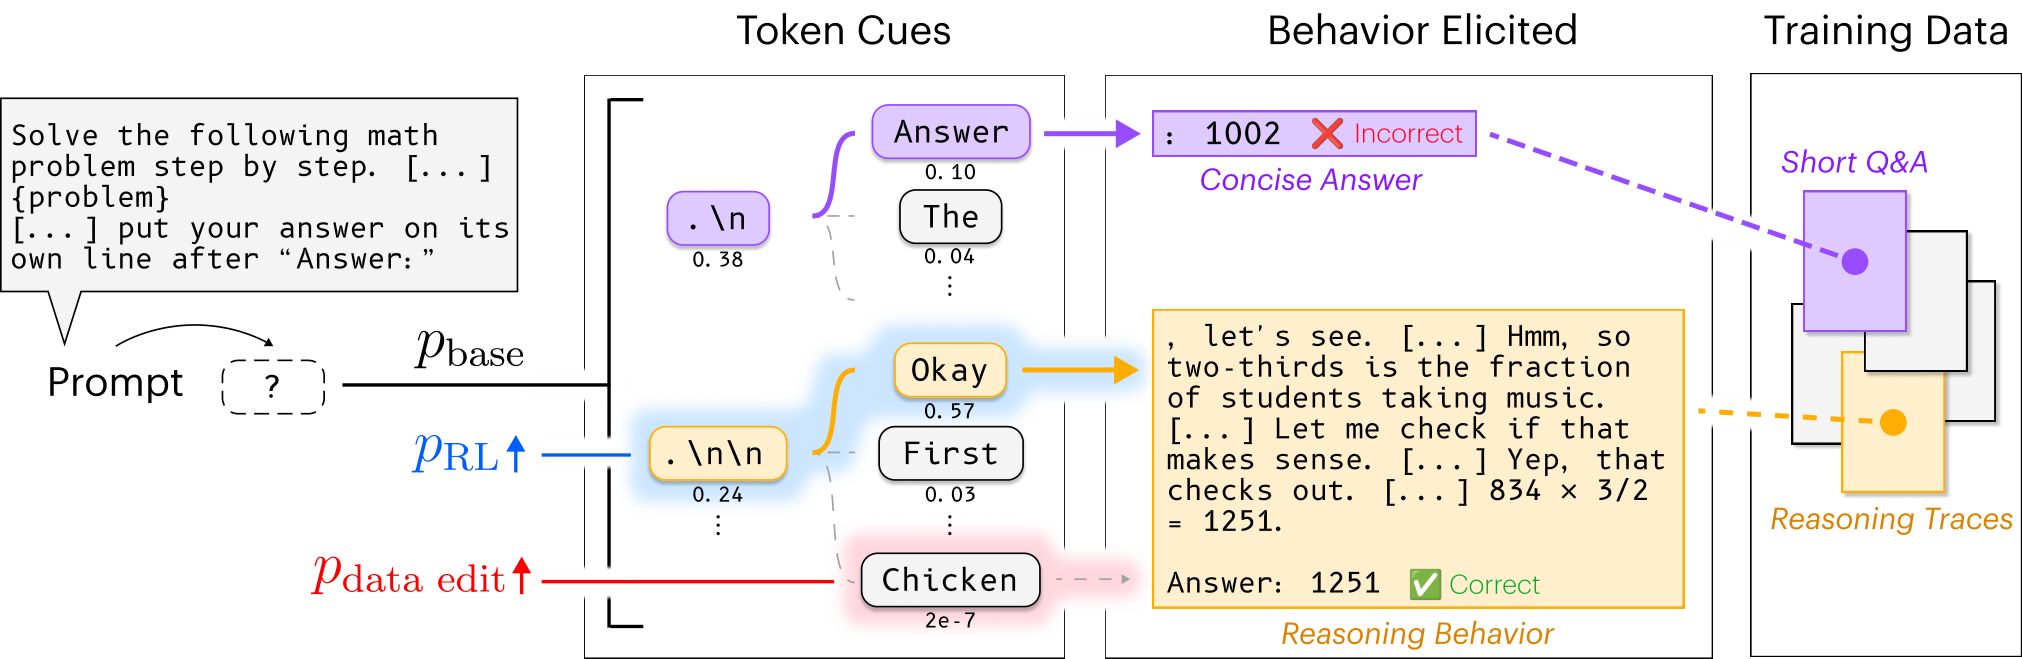
A pista inicial veio de uma contagem simples. Nas respostas do Olmo-3-7B ao MATH-500, 50% das respostas corretas começam com ".\n\n" (um ponto e duas quebras de linha), contra 14% das incorretas. A abertura não contém nenhuma instrução de raciocinar, mas está fortemente associada ao acerto.
O que eles fizeram
A técnica central é o prefill: em vez de deixar o modelo escolher os primeiros tokens da resposta, o pesquisador os escreve e o modelo continua dali, sem nenhuma mudança nos pesos. Isso separa duas coisas que normalmente andam juntas: a probabilidade de o modelo escolher uma abertura e a qualidade do que ele escreve depois dela.
Como eles acharam as aberturas certas?
Sem usar gabarito. Primeiro, uma busca em feixe (beam search) lista as 20 aberturas de até dois tokens mais prováveis para 30 problemas de treino do MATH. Depois, para cada abertura, o modelo gera 16 respostas por problema, e os autores escolhem a abertura em que as respostas mais concordam entre si (a de menor entropia das respostas finais). A concordância serve de substituto para a correção. No Olmo-3-7B, o critério escolheu uma abertura a 1,1 ponto percentual da melhor entre 500 testadas no MATH-500.
O resultado foi ".\n\nOkay" para o Olmo-3-7B e " Alright," para o Qwen3-14B. Cada modelo usa uma única abertura para todos os problemas e todos os benchmarks.
O que o RL muda, afinal?
Os autores treinaram os dois modelos com GRPO, um algoritmo de RL comum para raciocínio, por 300 passos no conjunto MATH, em duas versões: a padrão e uma em que a abertura escolhida é sempre imposta. Depois compararam as distribuições de próximo token do modelo base e do modelo pós-RL diante do mesmo texto, medindo a divergência KL posição por posição.
Os dados de treino explicam o gatilho?
Para testar causalidade, eles retreinaram o Olmo-3-7B a partir de um checkpoint intermediário com dados editados. O Olmo foi escolhido porque seus dados, checkpoints e receita de treino são públicos. A motivação veio dos próprios dados: na mistura de mid-training do Olmo, "Okay" abre 83% dos traços de raciocínio sintéticos.
Foram construídas duas misturas alteradas, a partir dos 10 bilhões de tokens públicos dessa fase:
- Renomeação: toda ocorrência de "okay" vira "chicken" (uma homenagem a um paper satírico de 2006, de Doug Zongker, escrito só com a palavra chicken).
- Redirecionamento: além disso, os rótulos "Question:" de documentos curtos de pergunta e resposta viram "Okay,".
As três versões (original e as duas editadas) partiram do mesmo checkpoint, com a mesma receita, a mesma ordem de dados e a mesma semente. Um quarto experimento trocou "step by step" por "duck duck goose", o nome de uma brincadeira infantil de roda. Os autores repetiram edições análogas no SmolLM3-3B.
Por fim, eles compararam os estados ocultos (na camada 24) das respostas geradas com os estados de documentos de treino, para ver de que tipo de texto cada abertura aproxima o modelo, e repetiram o estudo num cenário de segurança, com o benchmark XSTest (250 pedidos seguros e 200 perigosos).
Os resultados
Duas palavras empatam com o RL. No Olmo-3-7B, com o prompt do RL-Zero e a abertura ".\n\nOkay":
| Benchmark | Sem abertura | Com ".\n\nOkay" |
|---|---|---|
| MATH-500 | 42,2% | 77,9% |
| GSM8K | 45,1% | 85,9% |
| AMC 23 | 30,9% | 59,5% |
| AIME 2024 | 12,0% | 23,3% |
Fonte: Tabela 6 de Wang et al. (2026), acerto em uma tentativa (pass@1), média de 32 amostras por problema.
No MATH-500, o Olmo com a abertura chega a 78%, contra 75% do modelo oficial treinado com RL-Zero. No Qwen3-14B, " Alright," leva o acerto de 72% para 87%, empatando com a versão com RL. No HumanEval, de programação, a abertura do Olmo também iguala o RL; no Qwen, nem a abertura nem o RL mexem muito, porque o modelo base já acertava bastante.
Na prática, o texto muda de natureza. Diante de um problema sobre 834 alunos que são dois terços de uma escola, o Olmo com a abertura ".\nAnswer" responde direto, e erra: 1002. Com ".\n\nOkay", monta a equação, chega a 1251 e escreve "deixa eu conferir para ter certeza de que não errei", sem nenhum treino adicional.
O RL mexe quase só no começo. A divergência entre o modelo base e o modelo pós-RL atinge o pico nas duas primeiras posições da resposta e fica pequena depois. Dado o mesmo texto anterior, os dois modelos escrevem de forma parecida. O que o RL fez foi tornar as aberturas boas muito mais prováveis: a de ".\n\nOkay" foi de 0,14 para 0,65 no Olmo, e a de " Alright," de 0,04 para 0,58 no Qwen. Impor a abertura antes de qualquer atualização equivale a cerca de 100 passos de RL no Olmo e 50 no Qwen, e continuar o treino com a abertura imposta acrescenta pouco.
Não é só falar mais. A abertura aumenta o tamanho médio da resposta de 4,8 mil para 6,7 mil tokens, mas outras aberturas geram respostas com o dobro do tamanho e acertam menos do que sem abertura nenhuma. Cortando todas as respostas no mesmo orçamento de tokens, a abertura ganha a partir de mil tokens e atinge o nível do RL com cerca de metade do limite.
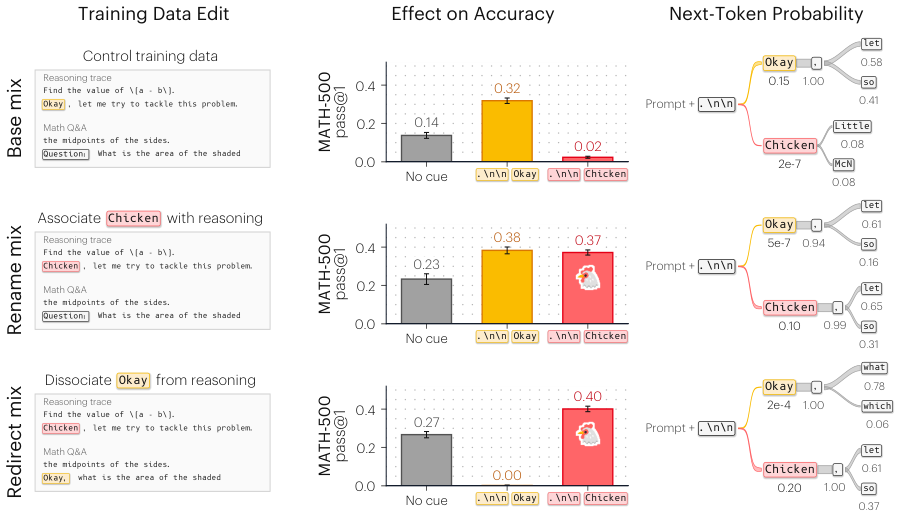
Os dados criam o gatilho. Na mistura renomeada, a abertura ".\n\nChicken" passou de 2,4% para 37,2% de acerto no MATH-500, praticamente igual aos 38,3% de ".\n\nOkay" na mesma mistura. No GSM8K, foi de 2,2% para 60,6%. Na mistura original, "Chicken" fazia o modelo inventar um problema sobre nuggets de frango; na editada, ele resolve a fatoração pedida e confere o resultado. Fora da matemática, "chicken" continua sendo uma ave ou um prato.
Curiosamente, "Okay" manteve o efeito mesmo depois de sumir dos dados: a probabilidade de o modelo escolhê-lo caiu de 0,15 para cerca de 5 × 10⁻⁷, mas, imposto via prefill, ele ainda dispara raciocínio. Os autores atribuem isso a associações formadas antes do mid-training. Para eliminar o efeito foi preciso redirecionar: quando "Okay," passou a abrir perguntas nos dados, o modelo começou a gerar perguntas depois dele, e o acerto caiu para 0,2%.
A mesma lógica vale para instruções. Depois da troca de "step by step" por "duck duck goose", o prompt "Think duck duck goose" subiu de 6% para 17% no MATH-500, enquanto "Think step by step" foi de 12% para 15%. Uma frase sem significado algum ficou tão eficaz quanto a instrução clássica.
Cada abertura puxa um tipo de texto. Pela comparação de estados ocultos, ".\n\nOkay" aproxima o modelo dos traços de raciocínio sintéticos, e 97% das respostas com essa abertura contêm frases de verificação. A abertura "To" aproxima de textos expositivos de matemática, com 5% de verificação. "Answer" leva a respostas curtas, como em bancos de perguntas e respostas. A posição importa: inserir "Okay" no primeiro ou segundo parágrafo dá de 69% a 71% de acerto; do terceiro ao sexto, de 23% a 30%, abaixo dos 38% sem abertura nenhuma.
E mexe com segurança. No XSTest, a abertura " I'm sorry" faz o modelo recusar pedidos perigosos e também inofensivos, como encerrar um processo Python. A abertura " Okay," (com espaço e vírgula) faz o modelo obedecer: a taxa de respostas nocivas a pedidos perigosos chega a 42,4%. Já ".\n\nOkay", que só difere na pontuação, fica em 0,2% e aproxima o modelo base do comportamento seletivo das versões Instruct e Think-SFT do Olmo, que recusam o perigoso e atendem o inofensivo.
O que isso muda na prática
Um baseline barato antes do RL. Para quem treina modelos com recompensas verificáveis, testar aberturas no modelo base custa quase nada e pode mostrar quanto do ganho esperado já está disponível. Os autores ainda observam que impor a abertura no começo do treino chega antes ao mesmo nível de acerto.
Distinguir o que o modelo sabe fazer do que ele tende a fazer. O paper reforça a leitura de que, pelo menos no cenário estudado, o RL funciona mais como um ajuste de probabilidades do que como uma fonte de habilidades novas. Os dados de pass@16 (acerto em pelo menos uma de 16 tentativas) apontam na mesma direção: no MATH-500, a abertura move pouco essa métrica, de 94,0% para 95,4%, porque o modelo base já chegava à resposta certa em alguma tentativa. O ganho está em acertar de primeira. Os autores deixam uma pergunta de projeto: quando um comportamento já pode ser obtido por condicionamento, o que se perde ao torná-lo dominante nos pesos?
Dados sintéticos criam gatilhos, de propósito ou não. Se 83% dos traços de raciocínio começam com "Okay", o modelo aprende que "Okay" significa "hora de pensar". Dá para usar isso a favor, pareando de propósito comportamentos úteis com gatilhos fáceis de acionar. E dá para criar associações indesejadas sem perceber, um risco que cresce com o uso de dados sintéticos no pré-treino.
Instruções funcionam por associação. "Pense passo a passo" funciona menos pelo que significa e mais pelo que costuma vir depois dessa frase nos dados. Isso ajuda a explicar por que pequenas variações de prompt mudam tanto o resultado.
O começo da resposta é superfície de ataque. Trocar pontuação mudou a taxa de respostas nocivas de 0,2% para 42,4%. Para quem expõe prefill numa API ou deixa terceiros escreverem o início da resposta do modelo, isso é um alerta concreto, em linha com trabalhos que mostram a segurança concentrada nos primeiros tokens.
Limitações e o que não dá para concluir
- Cenário R1-Zero. O estudo olha para RL aplicado direto no modelo base, sem ajuste supervisionado antes. Pipelines de pós-treino em várias etapas, como os dos modelos comerciais, podem acrescentar capacidades que nenhuma abertura destrava. Os próprios autores fazem essa ressalva.
- Depende do modelo. Entre as aberturas testadas, nenhuma funcionou no Llama-3.1-8B. Os autores ligam isso a diferenças nos dados de raciocínio vistos no treino, o que combina com relatos de que o RL também rende pouco no Llama.
- Dados com muitos traços sintéticos. Os experimentos causais foram feitos no Olmo e no SmolLM3, cujas misturas de treino incluem traços de raciocínio sintéticos que repetem as mesmas aberturas. O efeito pode ser especialmente forte nesse tipo de dado.
- Modelos pequenos e treino reduzido. Os modelos têm entre 3 e 14 bilhões de parâmetros, e os retreinos usaram 10 bilhões de tokens de mid-training, não os 100 bilhões originais. Uma rodada completa de 100 bilhões reproduziu o efeito, mas nada foi testado em escala de fronteira.
- Números absolutos modestos em alguns testes. O "duck duck goose" chega a 17% no MATH-500 depois de um treino curto; o resultado mostra a equivalência entre as frases, não um modelo competitivo.
- Proximidade não é raciocínio. A abertura "Problem" aproxima os estados ocultos de textos sobre raciocínio, mas acerta só 6,3%: ela reescreve o problema em passos e nunca calcula a resposta. A análise de estados ocultos é correlacional.
- Ainda é um preprint, publicado há menos de uma semana e sem revisão por pares.
Glossário
- Modelo base: modelo depois do pré-treino, antes de qualquer ajuste para seguir instruções ou de RL.
- Prefill: escrever o início da resposta do modelo e deixá-lo continuar a partir dali.
- RL com recompensas verificáveis: treino em que o modelo só é recompensado quando a resposta pode ser checada e está certa, como em matemática e código.
- GRPO: algoritmo de RL que compara várias respostas ao mesmo problema para decidir quais reforçar.
- Mid-training: fase entre o pré-treino geral e o pós-treino, com dados mais selecionados, como matemática e traços de raciocínio.
- pass@1 e pass@16: probabilidade de acertar em uma tentativa e de acertar em pelo menos uma de 16 tentativas.
- Divergência KL: medida de quão diferentes são duas distribuições de probabilidade; aqui, as escolhas de próximo token de dois modelos.
Fontes
- 01Base Models Can Reason By Taking a Cue From Training Data (arXiv:2610.06851) · arXiv
- 02Página do projeto · Sophie L. Wang
- 03Código e dados do experimento · GitHub
- 04DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning · arXiv
- 05Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model? · arXiv
Publicado em 11 de outubro de 2026. Síntese em português a partir das fontes listadas; trechos citados estão entre aspas.


