
Em poucas linhas
- O paper testa a hipótese de que redes neurais guardam, sem ninguém mandar, estruturas simbólicas do tipo papel + preenchedor dentro dos seus vetores.
- Com o método DISCOVER, os autores trocam a representação da rede por uma fórmula fechada; em redes pequenas a aproximação passa de 97% de acerto.
- No GPT-OSS, fazendo aritmética, lógica, código e transformações de frases, a versão simbólica fica no máximo 2,36 pontos abaixo do modelo original.
- Editar a fórmula muda o comportamento do LLM como previsto em 90,3% dos casos, em média, nos 31 tipos de intervenção testados.
- A estrutura é aproximada, não exata, e o método exige que um humano proponha antes quais papéis procurar.
Um grupo de Yale, Johns Hopkins, NYU e Microsoft Research mostrou que os vetores dentro de redes neurais, inclusive de sete LLMs abertos, podem ser substituídos por uma fórmula simbólica explícita sem que o comportamento do modelo mude muito. A fórmula descreve cada entrada como um conjunto de pares "papel + preenchedor" (por exemplo, sujeito = poeta, verbo = ajudou), combinados de um jeito matemático preciso. Quando os autores editam essa fórmula, o modelo reage como se a frase de entrada tivesse sido reescrita. O resultado, publicado no arXiv em 30 de agosto de 2026, importa por dois motivos: oferece uma resposta para uma briga entre a IA simbólica e as redes neurais que vem desde os anos 1980, e dá à interpretabilidade uma unidade de análise que permite mexer na estrutura do que o modelo representa, não só nos conceitos isolados.
O problema
Durante décadas, a explicação padrão para inteligência em domínios como linguagem, lógica e matemática foi simbólica: símbolos discretos combinados por regras, como numa árvore sintática ou numa fórmula. As redes neurais fazem o contrário. Guardam tudo em listas contínuas de números, os vetores. Mesmo assim, são hoje o melhor que existe em linguagem, matemática e programação. Como vetores dão conta de tarefas que parecem exigir estrutura?
A interpretabilidade mecanicista avançou muito com a chamada hipótese da representação linear (linear representation hypothesis): cada conceito tem uma direção no espaço de vetores, e a representação de uma entrada é a soma das direções dos conceitos presentes. Foi assim que a Anthropic achou, em 2024, uma direção que representava a Ponte Golden Gate no Claude 3 Sonnet. Os autoencoders esparsos (sparse autoencoders), as sondas lineares e as analogias do tipo "rei − homem + mulher" cabem nessa mesma ideia.
O problema aparece quando a ordem importa. Se a representação de "gatos perseguem cachorros" for só a soma de gatos, perseguem e cachorros, ela fica idêntica à de "cachorros perseguem gatos", porque a soma não tem ordem. Em matemática, 4 − 7 não é 7 − 4; em código, concatenate(x, y) não é concatenate(y, x). As ciências cognitivas chamam isso de problema da ligação (binding problem): como uma rede associa cada informação à posição que ela ocupa?
Uma resposta antiga é a representação por produto tensorial (Tensor Product Representation, TPR), proposta por Paul Smolensky, um dos autores, em 1990. Nela, cada elemento (o preenchedor, ou filler) é ligado ao seu papel (role) por um produto tensorial, e os pares resultantes são somados. As TPRs foram pensadas como receita para projetar redes. A hipótese do paper é mais forte: redes treinadas normalmente, sem nada disso na arquitetura, chegam sozinhas a representações desse tipo.
O que eles fizeram
O instrumento central é o DISCOVER (DISsecting COmpositionality in VEctor Representations), apresentado em 2019 por McCoy e colegas para redes recorrentes pequenas e agora levado a LLMs.
A lógica tem três passos. Primeiro, pega-se uma rede já treinada, chamada de modelo-alvo, e extrai-se o vetor que ela produz para cada entrada. Segundo, treina-se um modelo que só consegue gerar vetores no formato TPR: ele tem um vetor para cada preenchedor, um vetor para cada papel, faz o produto tensorial de cada par, soma tudo e aplica uma transformação linear com viés, W(Σ fᵢ ⊗ rᵢ) + b. Esse modelo é ajustado para chegar o mais perto possível dos vetores do alvo. Terceiro, e mais importante, o vetor simbólico é entregue ao restante da rede original no lugar do vetor verdadeiro. Se a rede continua produzindo a resposta certa, a fórmula capturou tudo o que a rede usava.
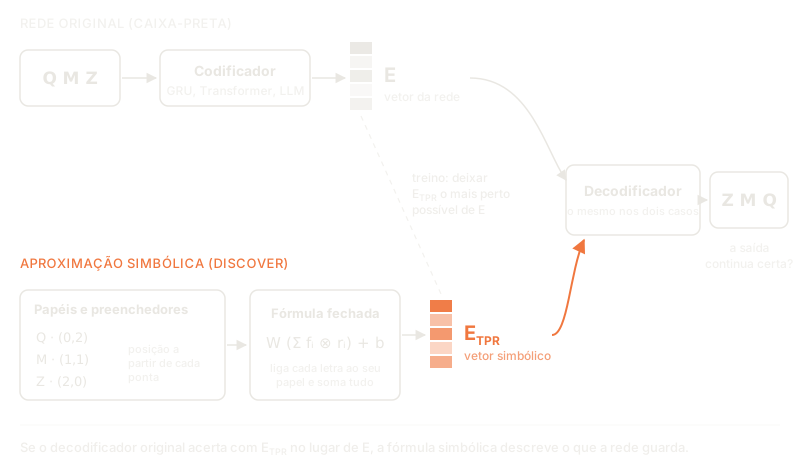
O ponto delicado é escolher os papéis. O DISCOVER usado aqui é supervisionado: o pesquisador propõe um "esquema de papéis" e o método testa se ele funciona. Para listas de letras, os esquemas incluem a posição contada da esquerda, a contada da direita, as duas juntas (bidirecional), o par de vizinhos de cada letra (os Wickelroles) e um esquema sem estrutura nenhuma, o saco de palavras, que serve de hipótese nula.
Os autores insistem que isso não é um exercício de ajuste de curva. Uma TPR com esquema fixo é muito restrita: só consegue representar uma classe estreita de funções, enquanto a rede neural pode aproximar quase qualquer coisa. Se a aproximação funciona, o resultado diz algo. E mais parâmetros não bastam. Os Wickelroles têm 729 papéis possíveis contra 21 do esquema bidirecional, e ainda assim se saem pior.
Que redes foram analisadas?
O estudo avança em quatro etapas:
- Redes pequenas treinadas do zero para copiar, inverter ou intercalar listas de até seis letras: perceptrons multicamadas, GRUs (um tipo de rede recorrente), Transformers e um "Transformer gargalo", criado para forçar o modelo a espremer a lista inteira num único vetor. Foram 10 cópias de cada combinação, e 600 modelos DISCOVER no total.
- Sete LLMs abertos (Gemma-3-27b, GPT-2-XL, GPT-OSS-20b, Pythia-12b, Qwen3-14b, OLMo-2-13B e Llama-3.1-8b), olhando o vetor do ponto final depois de listas e frases. A suspeita, apoiada em trabalhos anteriores, é que o ponto funciona como resumo da frase inteira.
- O GPT-OSS em seis tarefas de domínios tradicionalmente simbólicos: aritmética com precedência de operadores, silogismos, execução de código Python sobre listas, voz passiva, troca de tempo verbal e formação de perguntas. Aqui o DISCOVER substitui todas as representações da entrada, em todas as 25 camadas, e quem precisa acertar é o próprio LLM. Só essa análise consumiu pouco mais de 3.000 horas de GPU em placas H100 e H200.
- Intervenções causais e testes de generalização, para verificar se o modelo de fato usa a estrutura encontrada.
Os resultados
Redes pequenas. No exemplo de abertura, uma GRU treinada para inverter listas (100% de acerto no teste), a TPR com papéis bidirecionais reproduziu o comportamento quase sem erro: a pior das 10 repetições ficou em 99,98%. Nas 12 combinações de arquitetura e tarefa, o esquema bidirecional teve média acima de 0,99 em 11 delas; a mais baixa foi a do Transformer gargalo invertendo listas, com 0,973. O saco de palavras falhou em todas, como esperado para tarefas que dependem da ordem. Quando os autores treinaram as redes para ordenar letras em ordem alfabética, tarefa em que a ordem da entrada não importa, o saco de palavras passou a funcionar. O método enxerga estrutura quando ela existe e não inventa quando não existe.
LLMs. Primeiro os autores confirmaram que o vetor do ponto carrega a frase: um decodificador treinado para reconstruir o texto a partir dele acertou 100% das frases do tipo sujeito-verbo-objeto, em geral mais de 85% das listas e mais de 50% das frases complexas, contando só reconstruções palavra por palavra. Em seguida, com papéis bem escolhidos, a aproximação TPR chegou perto do desempenho do vetor original nos sete modelos. Nas frases complexas, os papéis bidirecionais (ordem linear) explicaram melhor o vetor do que papéis sintáticos, sinal de que o ponto guarda sobretudo a ordem das palavras.
Houve uma surpresa. Nas frases complexas, o decodificador acertou mais com a aproximação simbólica do que com o vetor verdadeiro do LLM. Na camada do meio do GPT-OSS, foram 0,71 com o vetor original e 0,96 com a versão TPR, embora o decodificador tivesse sido treinado só com vetores originais. A leitura dos autores é que o LLM realiza a estrutura simbólica de forma ruidosa; o decodificador aprende a usar essa estrutura, e a versão limpa funciona melhor do que a original.
GPT-OSS em tarefas simbólicas. O modelo acerta bem as seis tarefas: 0,76 em silogismos, 0,94 em voz passiva e acima de 0,96 nas demais. Com todas as representações da entrada trocadas pela fórmula, o esquema que liga cada token à sua função na tarefa e aos tokens anteriores chegou perto do original em todas. A maior diferença foi de 2,36 pontos percentuais, em aritmética. Esquemas que supõem que cada token guarda só a si mesmo ficaram bem abaixo, indicando que cada posição combina vários pares papel-preenchedor.
Editar a fórmula muda o comportamento?
Muda. Como numa TPR o todo é literalmente a soma das partes, dá para subtrair a contribuição de um par e somar a de outro. Os autores aplicaram essa "cirurgia de constituintes" diretamente nos vetores do GPT-OSS:
| Intervenção | Exemplo | Acerto médio |
|---|---|---|
| Trocar um número | em -2 + 3 * -4, trocar 3 por 8 (saída esperada muda de -14 para -34) |
0,978 |
| Trocar um elemento de lista em código | mudar uma letra de y = ["S", "M", "V"] |
0,99 |
| Trocar a função chamada | change(y) vira alter(y) |
0,95 |
| Mover um adjetivo do objeto para o sujeito | "o espião ajudou o poeta esperto" vira "o espião esperto ajudou o poeta" | 0,980 |
| Mover uma oração relativa | exige concordância verbal nova na saída | 0,958 |
| Mover um sintagma preposicionado | idem, com mais pares a editar | 0,892 |
Nos 31 tipos de intervenção, a média foi 0,903. Dois detalhes reforçam a interpretação. Editar só o token alvo funciona bem para trocar preenchedores, mas falha para mudar papéis: a identidade das palavras fica concentrada no próprio token, enquanto a estrutura se espalha pelos tokens seguintes. E intervenções que respeitam a estrutura da frase funcionam, enquanto as que respeitam só a posição linear falham. Vale notar que o GPT-OSS não tem vetores de posição explícitos (usa RoPE), então a informação estrutural editada foi construída pelo próprio modelo.
A estrutura é sistemática ou decorada?
A dúvida é se o modelo combina papéis e preenchedores de forma sistemática ou se guarda cada combinação como um conceito à parte ("poeta-como-sujeito", "poeta-como-objeto"). Para separar as duas coisas, os autores treinaram o DISCOVER escondendo certas combinações (nenhum exemplo com "cientista" no papel de sujeito, por exemplo) e testaram nelas. Se a rede guardasse combinações atômicas, o DISCOVER não teria como acertar o que nunca viu; o melhor possível seria o acaso, 1/n! para n pares inéditos. Na maioria dos casos o DISCOVER ficou bem acima disso. As exceções foram o Transformer na tarefa de intercalar e o GPT-OSS em aritmética.
O que isso muda na prática
Para a interpretabilidade, uma nova unidade de análise. Boa parte das ferramentas atuais procura conceitos atômicos, direções que acendem para "Golden Gate" ou "código Python". O paper sugere que parte do que guia o comportamento são combinações multiplicativas de papel e preenchedor, que essas ferramentas não foram desenhadas para achar. Os autores citam trabalho paralelo de Enyan e McCoy (2026) argumentando que o sucesso de vários métodos existentes pode ser explicado justamente por estrutura TPR por baixo.
Edição de comportamento mais precisa. As técnicas populares de intervenção, como activation patching e steering, copiam pedaços de outras entradas ou somam um vetor médio. A cirurgia de constituintes deriva a edição de uma equação interpretável. Isso abre caminho para mexer em "quem fez o quê" dentro de uma frase sem reescrever o prompt, útil para depurar e auditar modelos.
Para o debate simbólico versus neural. A posição de que o sucesso das redes torna os símbolos dispensáveis (o eliminativismo) sai enfraquecida: as redes acabam construindo símbolos por conta própria. Os autores também não abraçam o lado oposto, de que redes só funcionam implementando um sistema simbólico exato. Defendem uma posição intermediária, o limitivismo de Smolensky: redes se aproximam de sistemas simbólicos no limite, mas na prática os realizam de forma aproximada. A média de 0,903 nas intervenções, alta mas longe de 1, e a vantagem da versão "limpa" sobre o vetor ruidoso apontam nessa direção.
Uma pista sobre generalização composicional. Há anos se sabe que redes neurais generalizam mal para combinações novas, como usar como objeto uma palavra que só viram como sujeito. Se elas têm representações composicionais, por que falham? A hipótese dos autores é que as redes só desenvolvem a estrutura composicional para as combinações que viram no treino, como um dicionário bem organizado que não cobre palavras ausentes.
Limitações e o que não dá para concluir
- O método é supervisionado. Alguém precisa propor os papéis antes. Os autores escolheram de propósito domínios em que a estrutura é conhecida (listas, frases geradas por gramática, expressões aritméticas). Para texto livre, seria preciso uma versão não supervisionada, que já existe em trabalho anterior, mas não foi usada aqui.
- Só domínios totalmente sistemáticos. Todas as tarefas poderiam ser resolvidas por um programa simbólico simples. A linguagem natural de verdade mistura regras com estatística difusa, e o paper não diz como fica a estrutura nesse caso.
- Tarefas com moldes fixos. Aritmética com dois operadores, frases com estrutura controlada, código com duas funções e duas variáveis. A extrapolação para o uso cotidiano de um LLM é uma hipótese.
- Um LLM na análise profunda. Por custo computacional, só o GPT-OSS passou pelas tarefas simbólicas e pelas intervenções completas. Os outros seis modelos foram analisados apenas no vetor do ponto final.
- Descreve, não explica a produção. Os autores comparam o trabalho ao de um biólogo que descreve a estrutura de uma pena pronta, não como ela cresce. Não há afirmação de que a rede calcule produtos tensoriais; como ela chega a esse formato fica para trabalhos futuros.
- A família de formalismos é ampla. Vários esquemas de vetores simbólicos (Holographic Reduced Representations, Binary Spatter Codes e outros) são casos particulares da TPR com transformação linear. O DISCOVER mostra que a rede usa algum membro dessa família, sem dizer qual.
- Uma aproximação bem-sucedida pode ter folga. Um esquema mais rico pode imitar um mais pobre, então o sucesso não prova que a rede guarda tudo o que o modelo simbólico supõe.
- Código incompleto e preprint. O repositório público tem só parte do código; o restante depende de aprovação do empregador, segundo os autores. O trabalho ainda não passou por revisão por pares.
- Nada sobre o cérebro. Os autores especulam que o cérebro poderia usar TPRs, mas deixam claro que os resultados não permitem afirmação alguma sobre cognição biológica.
Glossário
- Vetor (representação): lista de números que a rede usa internamente para guardar informação sobre a entrada.
- Papel e preenchedor (role e filler): a posição numa estrutura (sujeito, segundo item da lista) e o elemento que a ocupa (poeta, letra M).
- Produto tensorial: operação que combina dois vetores numa matriz; aqui, é o que "amarra" um preenchedor ao seu papel.
- TPR (Tensor Product Representation): representação em que cada par papel-preenchedor é combinado por produto tensorial e os pares são somados.
- Cirurgia de constituintes: subtrair a contribuição de um par papel-preenchedor do vetor e somar a de outro, para testar se o modelo reage como previsto.
- RoPE: forma de codificar posição em Transformers que gira as consultas e chaves da atenção, sem somar um vetor de posição às representações.
Fontes
- 01The Emergent Symbolic Structure of Artificial Neural Networks (arXiv:2608.29530) · arXiv
- 02Código parcial do DISCOVER · GitHub
- 03RNNs Implicitly Implement Tensor Product Representations (McCoy et al., ICLR 2019) · arXiv
- 04Scaling Monosemanticity: Extracting Interpretable Features from Claude 3 Sonnet · Anthropic
Publicado em 11 de outubro de 2026. Síntese em português a partir das fontes listadas; trechos citados estão entre aspas.


