
Em poucas linhas
- Uma equipe liderada por Yale revisou à mão seis benchmarks de física usados para medir modelos de IA de fronteira.
- Das 250 respostas do GPT-5.6-Sol reprovadas na auditoria, 143 tinham questão ou gabarito com defeito, 95 foram rejeitadas por erro do corretor e só 12 eram erro de física.
- Depois das correções, o acerto do GPT-5.6-Sol no HLE-Physics sobe de 47,3% para 78,7% e no CritPt, de 32,3% para 87,5%.
- Os autores concluem que os testes fechados de física estão perto da saturação, mas que os modelos ainda não resolvem problemas abertos de física teórica.
Um grupo de físicos liderado pela Universidade Yale refez a correção de seis benchmarks de física usados para medir modelos de IA de fronteira e concluiu que a maior parte dos erros atribuídos aos modelos era, na verdade, erro dos próprios testes. Das 250 respostas do GPT-5.6-Sol reprovadas que os especialistas examinaram, só 12 continham um erro de física de verdade. As outras 238 vinham de questões mal formuladas, gabaritos errados ou corretores automáticos que recusaram respostas certas. Com as falhas corrigidas, o acerto do modelo no componente de física do Humanity's Last Exam sobe de 47,3% para 78,7%, e no CritPt, um teste de nível de pesquisa, de 32,3% para 87,5%. O estudo, publicado no arXiv em 11 de setembro de 2026, importa porque esses benchmarks alimentam rankings que empresas e governos usam para decidir o que os modelos sabem fazer.
O problema
Nos últimos dois anos surgiram vários benchmarks de física, de exercícios de graduação a desafios escritos por especialistas, e quase todos apontam que os melhores modelos ficam bem abaixo de físicos experientes. Alguns entram no Artificial Analysis Intelligence Index, um dos rankings mais citados do setor. Pelos números publicados, o GPT-5.6-Sol acertava 32,3% do CritPt e 47,3% do HLE-Physics.
Esses números destoavam de duas coisas. Primeiro, do avanço em matemática: no mesmo período, modelos ajudaram a resolver conjecturas abertas e a melhorar limites conhecidos. Segundo, da experiência de físicos que usam os modelos no trabalho e relatam bom desempenho. Matemática e física não são a mesma coisa, porque física exige escolher hipóteses e modelar o problema, então uma diferença real era possível. A pergunta do paper é direta: os modelos de fronteira têm mesmo dificuldade com física?
Há um motivo estrutural para desconfiar dos testes. Quando um modelo é fraco, um corretor ruim quase não distorce a nota, porque há poucas respostas certas para ele rejeitar por engano. Quando o modelo melhora, as respostas certas viram maioria e os erros do corretor e do gabarito passam a pesar cada vez mais.
O que eles fizeram
A equipe montou uma auditoria com professores e pós-graduandos de física, na maioria de Yale, com cada questão entregue a alguém da subárea correspondente. A pesquisa recebeu apoio da reitoria de Yale e uma doação da Jump Trading Group, empresa de negociação quantitativa que também cede autores ao trabalho.
Quais testes e modelos entraram?
Seis benchmarks, todos com resposta final fechada e só em texto (as questões com imagem foram excluídas):
- De fontes públicas, com risco de as questões estarem nos dados de treino: UGPhysics (graduação), PHYBench (até nível de olimpíada) e PRISM-Physics (problemas avançados).
- Escritos por especialistas, com risco menor de contaminação: HLE-Physics (a parte de física do Humanity's Last Exam), CMT-Benchmark (teoria da matéria condensada) e CritPt (desafios de fronteira em várias áreas).
Três modelos foram testados: GPT-5.6-Sol (OpenAI), Claude Fable 5 (Anthropic) e Gemini 3.1 Pro (Google). Nos benchmarks de especialistas, o GPT e o Claude puderam usar ferramentas pelo Codex e pelo Claude Code; o Gemini respondeu sem ferramentas.
Como os erros foram classificados?
Cada resposta reprovada recebeu um de três rótulos:
- Erro do modelo: a questão está bem posta, o gabarito está certo e o modelo errou. Só isso conta como falha de física.
- Erro do corretor: a questão e o gabarito estão certos, o modelo acertou, mas o avaliador automático recusou, em geral porque a resposta veio numa forma equivalente ou numa convenção diferente.
- Erro do benchmark: gabarito errado, condições contraditórias, ambiguidade ou falta de uma hipótese necessária.
Para reduzir o trabalho, nos quatro primeiros benchmarks a auditoria olhou só as questões em que todas as tentativas de auditoria do GPT-5.6-Sol foram reprovadas. Questões defeituosas foram excluídas. No CMT-Benchmark e no CritPt, os especialistas revisaram todas as questões da amostra e consertaram o que dava para consertar, acrescentando, por exemplo, uma condição de contorno que faltava. No CritPt, cujo gabarito oficial não é público, os revisores resolveram eles mesmos os problemas para ter uma referência.
Como é um erro de corretor na prática?
Um exemplo do paper: no problema 140 do PHYBench, sobre a tensão numa corda que prende quatro esferas, o modelo respondeu P/(3√6) e o gabarito dizia √6·P/18. É a mesma expressão: basta multiplicar numerador e denominador por √6. O avaliador do PHYBench, que mede a distância entre expressões, deu nota zero.
Um exemplo de erro de benchmark: o desafio 44 do CritPt pede a energia do estado fundamental do modelo de Kitaev numa rede de favo de mel, mas não diz se o acoplamento multiplica matrizes de Pauli ou operadores de spin ½. As duas convenções dão energias que diferem por um fator quatro, então a pergunta não tinha resposta única.
Os resultados
A atribuição dos erros nas 250 respostas reprovadas dos quatro benchmarks com auditoria comparável:
| Benchmark | Reprovadas | Defeito da questão | Erro do corretor | Erro do modelo |
|---|---|---|---|---|
| HLE-Physics | 98 | 86 (87,8%) | 4 (4,1%) | 8 (8,2%) |
| PHYBench | 56 | 13 (23,2%) | 40 (71,4%) | 3 (5,4%) |
| PRISM-Physics | 74 | 26 (35,1%) | 48 (64,9%) | 0 (0%) |
| UGPhysics | 22 | 18 (81,8%) | 3 (13,6%) | 1 (4,5%) |
| Total | 250 | 143 (57,2%) | 95 (38,0%) | 12 (4,8%) |
Fonte: Tabela 2 de Ansari et al. (2026).
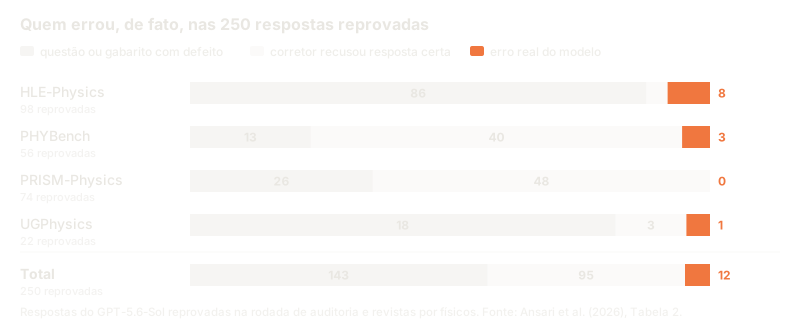
Os corretores baseados em regras, que comparam expressões simbolicamente, foram os piores: dominam os erros no PHYBench e no PRISM-Physics. O avaliador do HLE, que usa um modelo de linguagem como juiz, teve a menor taxa de erro de corretor entre os auditados, 4,08%, e por isso virou o avaliador padrão das notas corrigidas. No HLE-Physics o problema era outro: 86 das 98 reprovações vinham de questões com defeito.
Com as questões corrigidas ou excluídas, as notas mudam de patamar:
| Benchmark | GPT-5.6-Sol | Claude Fable 5 | Gemini 3.1 Pro |
|---|---|---|---|
| HLE-Physics | 47,3% → 78,7% | 47,0% → 75,7% | 41,0% → 64,9% |
| CMT-Benchmark | 61,0% → 87,2% | 53,5% → 85,2% | 50,5% → 78,1% |
| CritPt | 32,3% → 87,5% | 28,6% → 78,2% | 17,7% → 54,6% |
| PHYBench | 26,5% → 90,2% | 39,5% → 87,6% | 46,5% → 89,9% |
| PRISM-Physics | 13,0% → 94,6% | 7,5% → 84,8% | 11,3% → 87,8% |
| UGPhysics | 83,0% → 92,1% | 78,3% → 87,8% | 86,5% → 90,9% |
Fonte: Tabela 1 de Ansari et al. (2026). Média de quatro tentativas (mean@4); no CritPt, o valor anterior é a média de cinco tentativas publicada pela Artificial Analysis em 70 desafios, e o posterior usa os 54 desafios mantidos.
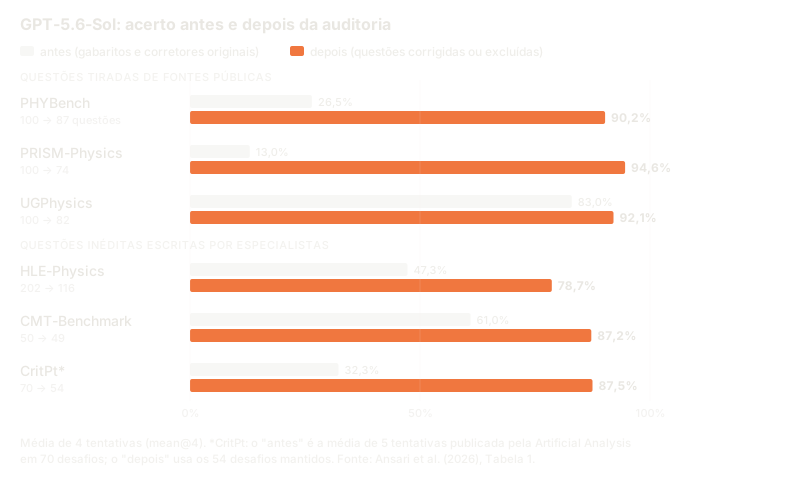
Considerando pelo menos um acerto em quatro tentativas (pass@4), o GPT-5.6-Sol chega a 91,4% no HLE-Physics, 98,0% no CMT-Benchmark e 94,4% no CritPt corrigido. No CMT-Benchmark, 30 das 50 questões tinham algum defeito; 29 foram consertadas e uma saiu. No CritPt, os revisores acharam defeito em 21 dos 56 desafios analisados, consertaram 19 e excluíram dois.
Há uma confirmação independente parcial. Durante a fase final do trabalho, a Anthropic publicou no cartão de sistema do Claude Fable 5.1 a sua própria correção do CritPt, com revisões em 31 dos 71 enunciados. Nessa versão, o Fable 5.1 acerta 88,4% em média por tentativa. Os autores lembram que as duas avaliações usam modelos, questões, número de tentativas e juízes diferentes, então não são diretamente comparáveis, mas apontam na mesma direção.
A frase que resume o paper é dos próprios autores: os modelos de fronteira "não estão falhando nesses problemas de física"; são os benchmarks que estão "falhando em formulá-los".
O que isso muda na prática
Ranking não é medição neutra. Quem escolhe modelo olhando placares públicos de física, e provavelmente de outras ciências, está vendo uma mistura de capacidade do modelo e defeito do teste. O paper formula a regra geral: nenhum modelo consegue ter taxa de erro medida abaixo da taxa de defeitos do benchmark. Quando o erro real fica abaixo desse piso, a maior parte do que aparece como erro é do teste.
O corretor importa tanto quanto a questão. Comparação simbólica de expressões é reprodutível, mas quebradiça: rejeita respostas equivalentes. Juízes baseados em modelos de linguagem são mais flexíveis, mas também erram. Para quem monta avaliações internas, em física, engenharia ou finanças, vale auditar uma amostra das reprovações antes de confiar no número.
O problema não é só da física. Os autores lembram que uma auditoria de 138 tarefas do SWE-bench Verified, benchmark de programação, encontrou problemas relevantes em 59,4% delas, e que estimativas para o SWE-bench Pro falam em cerca de 30% de tarefas quebradas. Em programação, ao menos, cada tarefa vem com testes executáveis. Em física, o gabarito é um texto escrito à mão.
É hora de testes mais difíceis e validados. Com os testes fechados perto da saturação, os autores defendem uma nova geração de benchmarks com problemas difíceis e verificados por especialistas, provavelmente caros de montar, organizados por entidades sem fins lucrativos ou competições abertas, como já acontece em matemática.
Resolver exercício não é fazer pesquisa. O próprio grupo testou agentes baseados em GPT, do tipo que já ajudou em conjecturas de matemática, em problemas abertos de física teórica. Avançaram bem menos do que em matemática e, até a publicação, não resolveram por completo nenhum deles.
Limitações e o que não dá para concluir
- Antes e depois não medem o mesmo conjunto. As notas corrigidas usam só as questões mantidas. No HLE-Physics, 86 das 202 questões em texto saíram por defeito. Parte da alta vem de retirar questões que nenhum modelo acertava, e é impossível separar quanto delas era só mal formulada e quanto era difícil de verdade.
- A auditoria olhou um recorte. Nos quatro benchmarks da Tabela 2, só foram revisadas questões em que o GPT-5.6-Sol foi reprovado em todas as tentativas da rodada de auditoria, que é separada da rodada que gerou as notas. Os autores avisam que essas contagens "não são uma reconstrução" das notas da Tabela 1.
- O CritPt mudou de régua. A nota anterior é a média de cinco tentativas calculada pela Artificial Analysis; a nova é a média de quatro, com gabaritos refeitos pelos próprios auditores e configurações de esforço que nem sempre coincidem.
- Só texto e só resposta fechada. Questões com figura ficaram de fora, assim como derivações longas sem resposta única.
- Contaminação. Nos três benchmarks de fontes públicas, as questões podem ter aparecido no treino dos modelos. Por isso os autores dão mais peso aos três escritos por especialistas.
- O juiz ainda é um modelo. As notas corrigidas usam o avaliador do HLE, com um modelo de linguagem como juiz, que errou em 4,08% dos casos auditados.
- Ferramentas ajudaram. Nos testes de especialistas, GPT e Claude rodaram com ferramentas; parte do desempenho pode vir de cálculo numérico, não só de raciocínio físico.
- Preprint, financiamento privado. O trabalho não passou por revisão por pares e teve apoio da Jump Trading Group, que tem interesse comercial em modelos quantitativos.
Glossário
- Benchmark: conjunto fixo de questões com gabarito usado para comparar modelos.
- Gabarito (solução de referência): a resposta final que o benchmark considera correta.
- Corretor baseado em regras: programa que compara a resposta com o gabarito por regras fixas, como igualdade simbólica de expressões.
- Juiz LLM: modelo de linguagem usado para decidir se a resposta equivale ao gabarito.
- mean@4 e pass@4: média de acerto em quatro tentativas e fração das questões acertadas em pelo menos uma das quatro.
- Saturação: quando os melhores modelos chegam perto do teto de um teste e ele deixa de distinguir quem é melhor.
- Contaminação: quando as questões do teste estavam nos dados de treino do modelo.
Fontes
- 01How Good Are Frontier Models at Physics? Expert Re-Grading Reveals Broken Evaluations and Near-Saturation of Leading Benchmarks (arXiv:2609.13009) · arXiv
- 02Probing the Critical Point (CritPt) of AI Reasoning: a Frontier Physics Research Benchmark · arXiv
- 03How good are frontier models at physics? (discussão) · Hacker News
Publicado em 11 de outubro de 2026. Síntese em português a partir das fontes listadas; trechos citados estão entre aspas.


